
Mistral-7B-Instruct-v0.2
Mistral-7B-Instruct-v0.2 是由 MistralAI 发布的 AI 模型,发布时间为 2023-11-11,定位为 聊天大模型,参数规模约为 73亿,上下文长度为 32K,模型文件大小约 15GB,采用 Apache 2.0 许可,在 MMLU-Pro 上取得 30.84 分。
数据优先来自官方发布(GitHub、Hugging Face、论文),其次为评测基准官方结果,最后为第三方评测机构数据。 了解数据收集方法
模型基本信息
开源和体验地址
官方介绍与博客
API接口信息
评测结果
发布机构

模型解读
Mistral-7B-Instruct-v0.2是MistralAI最新开源的70亿参数大语言模型,是此前Mistral-7B-Instruct-v0.1的升级版本,基于Mistral-7B-v0.2版本微调得到。
Mistral-7B-v0.2于2024年3月24日直接开源,并没有在官方做任何宣传和比较,参考: https://www.datalearner.com/ai-models/pretrained-models/mistral-7B-v0_2
在2023年9月27日,MistralAI宣布以Apache2.0开源协议开源Mistral 7B。当时,Mistral 7B已经在多项开源测试的表现中超过了Llama1 34B和Llama2 13B。并且代码能力也很强,支持欧洲多国语言,进而受到了广泛的关注。同时发布的还有基于Mistral 7B微调的Mistral 7B Instruct-v0.1版本。具体信息参考: https://www.datalearner.com/ai-models/pretrained-models/Mistral-7B
此次发布的Mistral-7B-Instruct-v0.2是基于Mistral-7B-v0.2做指令微调得到的。相比较Mistral-7B-Instruct-v0.1的主要改进如下:
- 上下文长度由4K扩展到了32K
- Rope Theta的参数变为了1e6
- 去掉了滑动窗口
第一个变动很容易理解,这意味着Mistral-7B-Instruct-v0.2在长的上下文场景下表现会更好。
而第二个参数可能很多人不知道。Rope Theta是一个在大语言模型训练过程中使用的参数,用于优化大型语言模型训练的算法,它可以帮助解决梯度爆炸和梯度消失的问题。Rope Theta限制梯度值在一个合理范围内,避免出现极大或极小的梯度值。从这个角度看,Mistral-7B-Instruct-v0.2调高了Rope Theta,模型能力更强,但是训练过程就不那么稳定了。
第三个是取消了滑动窗口,这意味着此前Mistral-7B-v0.1在训练过程中使用了滑动窗口,即将输入序列切分成小的chunks训练。取消的话一般会让模型对长上下文有更好的表现,但是训练过程一般会变慢。
从上述描述看,Mistral-7B-Instruct-v0.2的提升应该是不大,但是对于已经应用的人来说,这些提升无疑是有价值的。在某些方面可能会有令人期待的表现(例如支持更长的输入)。官方也有一个图来对Mistral-7B-Instruct-v0.2与其它模型的区别:

在去年九月份的时候,这对比如下:
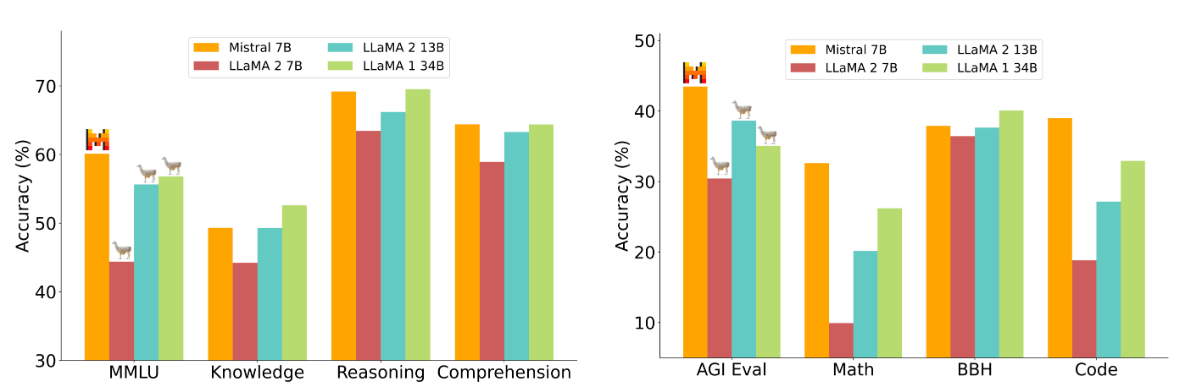
从MMLU和Knowledge的纵轴看,有一点提升~
DataLearner 官方微信
欢迎关注 DataLearner 官方微信,获得最新 AI 技术推送
