
吴恩达再开新课程!如何基于大语言模型实现更强大的语义搜索课程!
刚刚,吴恩达宣布deeplearning.ai 与 Cohere 合作推出了一个新课程:“Large Language Models with Semantic Search”。这个课程主要教授大家如何使用LLMs进行语义搜索,还提供了大量实践经验,来克服搜索结果和准确性等挑战。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
刚刚,吴恩达宣布deeplearning.ai 与 Cohere 合作推出了一个新课程:“Large Language Models with Semantic Search”。这个课程主要教授大家如何使用LLMs进行语义搜索,还提供了大量实践经验,来克服搜索结果和准确性等挑战。
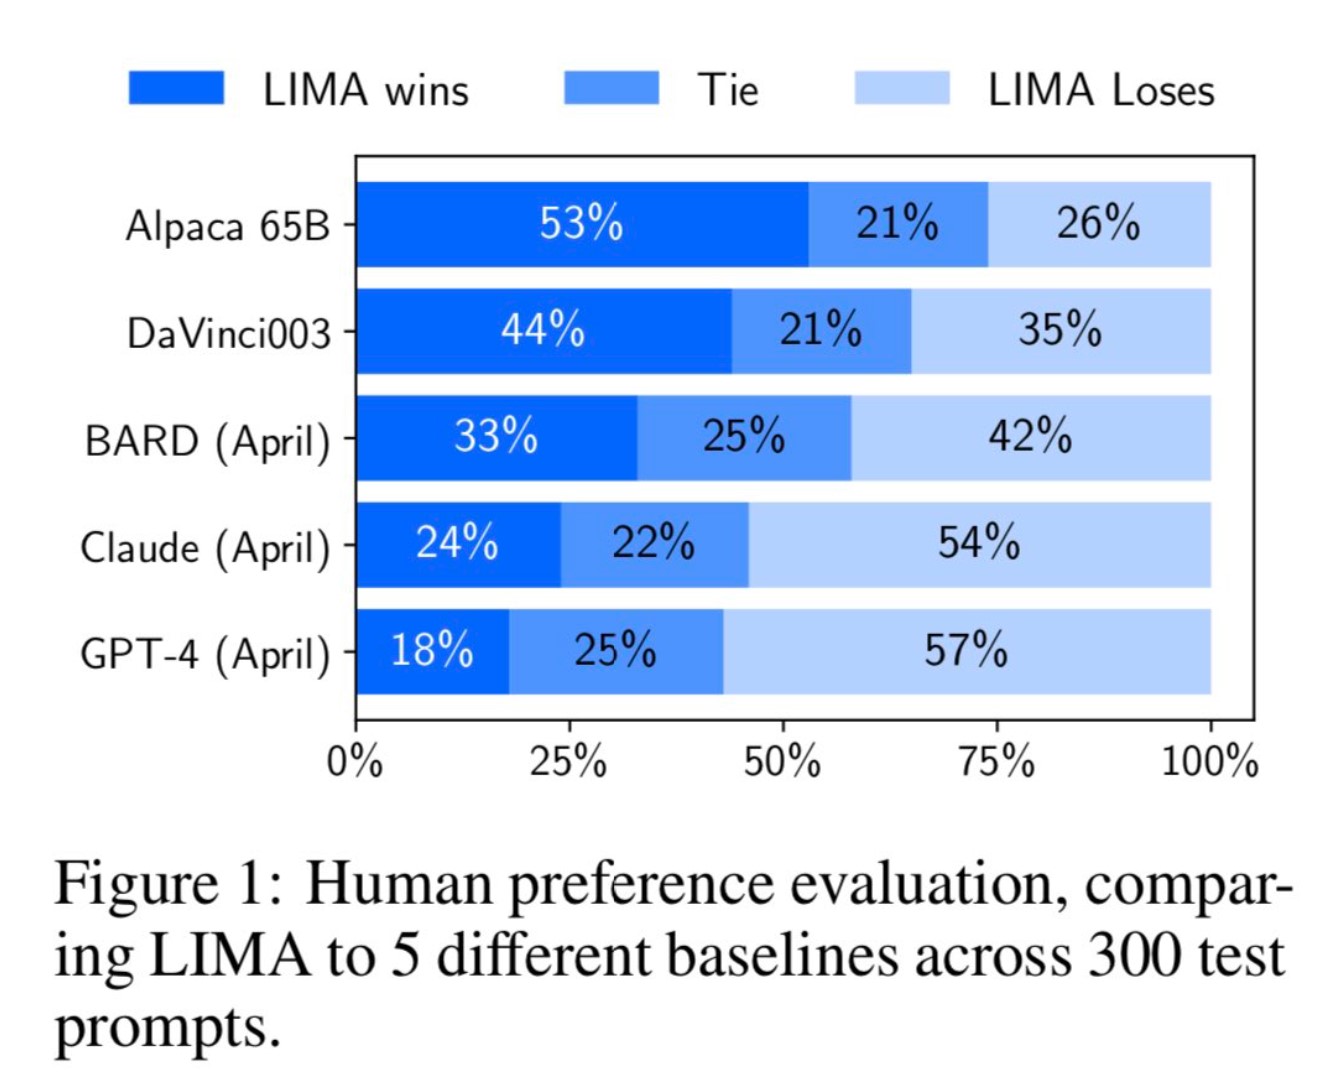
MetaAI最近公布了一个新的大语言模型预训练方法(LIMA: Less Is More for Alignment)。它最大的特点是不使用ChatGPT那样的(Reinforcement Learning from Human Feedback,RLHF)方法进行对齐训练。而是利用1000个精选的prompts与response来对模型进行微调,但却表现出了极其强大的性能。能够从训练数据中的少数几个示例中学习遵循特定的响应格式,包括从规划旅行行程到推测关于交替历史的复杂查询。

PinchBench 是 Kilo Code 团队开发的开源基准测试系统,用于评估大型语言模型作为 OpenClaw 编码代理核心的表现。该系统运行一组固定真实世界任务,计算代理的任务完成成功率,同时记录执行速度和成本。所有结果通过公开排行榜 https://pinchbench.com 显示,目前包含 50 个模型的 403 次运行记录,最新更新时间为 2026 年 3 月 18 日。基准测试的代码和任务定义全部开源在 GitHub(pinchbench/skill 仓库),任何开发者均可本地复现或添加
最近,随着ChatGPT的火爆,大语言模型(Large language model)再次被大家所关注。当年BERT横空出世的时候,基于BERT做微调风靡全球。但是,最新的大语言模型如ChatGPT都使用强化学习来做微调,而不是用之前大家所知道的有监督的学习。这是为什么呢?著名AI研究员Sebastian Raschka解释了这样一个很重要的转变。大约有5个原因促使了这一转变。
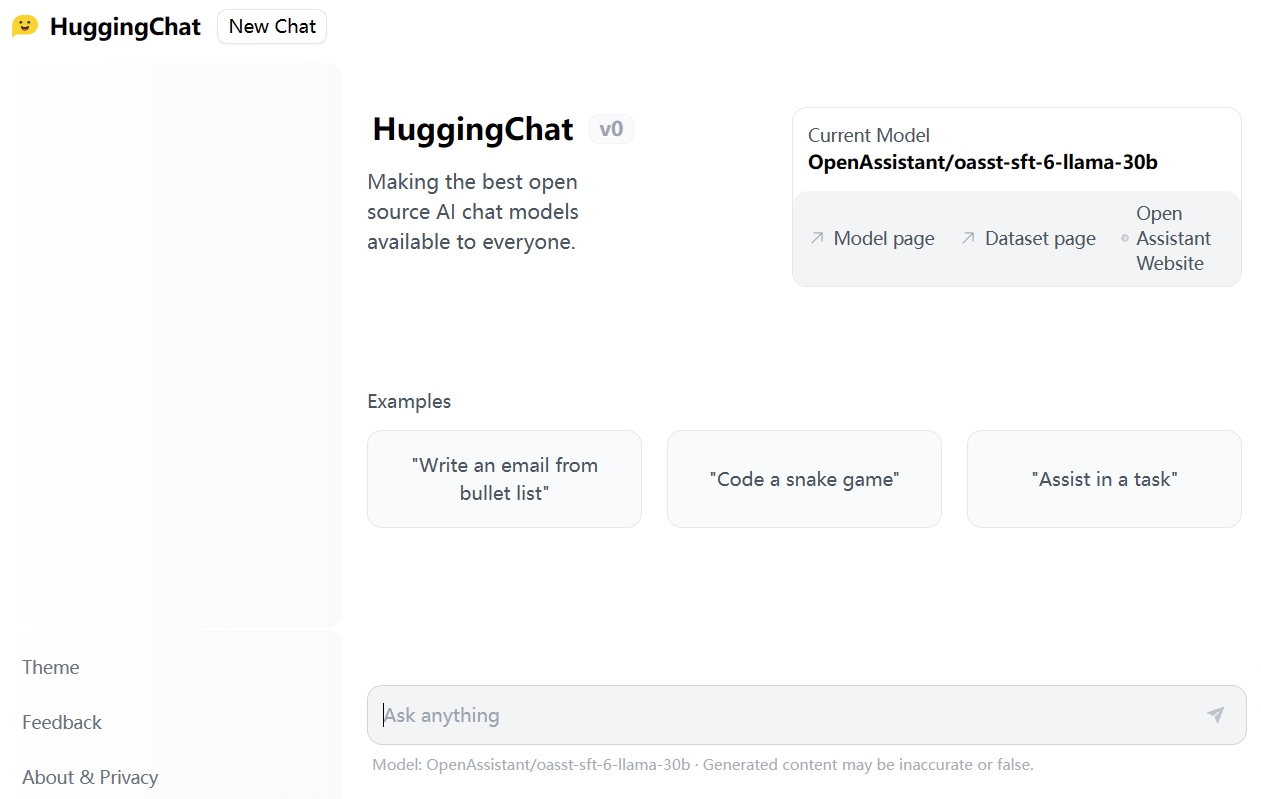
HuggingFace是近几年最火热的AI社区,在短短几年时间里已经称为AI模型的GitHub。目前,HuggingFace上已经托管了18万多的模型、3万多的数据集以及4万多的模型demo(spaces)。今天,HuggingFace发布了HuggingChat,声称要做最好的开源AI Chat项目,并且对所有人开放。
12月8日晚上,MistralAI在他们的推特账号上发布了一个磁力链接,大家下载之后根据名字推断这是一个混合专家模型(Mixture of Experts,MoE)。这种模型因为较低的成本和更高的性能被认为是大模型技术中非常重要的路径。也是GPT-4可能的方案。MistralAI在今天发布了博客,正式介绍了这个强大的模型。
2025年3月20日,OpenAI 推出了三款新模型——gpt-4o-transcribe、gpt-4o-mini-transcribe 和 gpt-4o-mini-tts——标志着自动语音识别 (ASR) 和文本转语音 (TTS) 领域的重要进步。这些模型基于 GPT-4o 架构,旨在为开发人员和用户提高准确性、自定义能力和可访问性,与 OpenAI 对于代理式 AI 系统的更广泛愿景一致。本文提供了对每个模型、其能力、定价、可用性和竞争环境的详细审查,确保技术和非技术受众都能全面理解。
xAI是马斯克在2023年3月份创办的一家大模型初创企业。因为ChatGPT过于火爆,离开OpenAI之后马斯克又再次开始推出大模型,就是这个Grok。xAI今天也宣布了Grok模型的细节。其在多个知名榜单评测上的得分结果超过了ChatGPT-3.5水平。本文详细介绍一下这个模型。
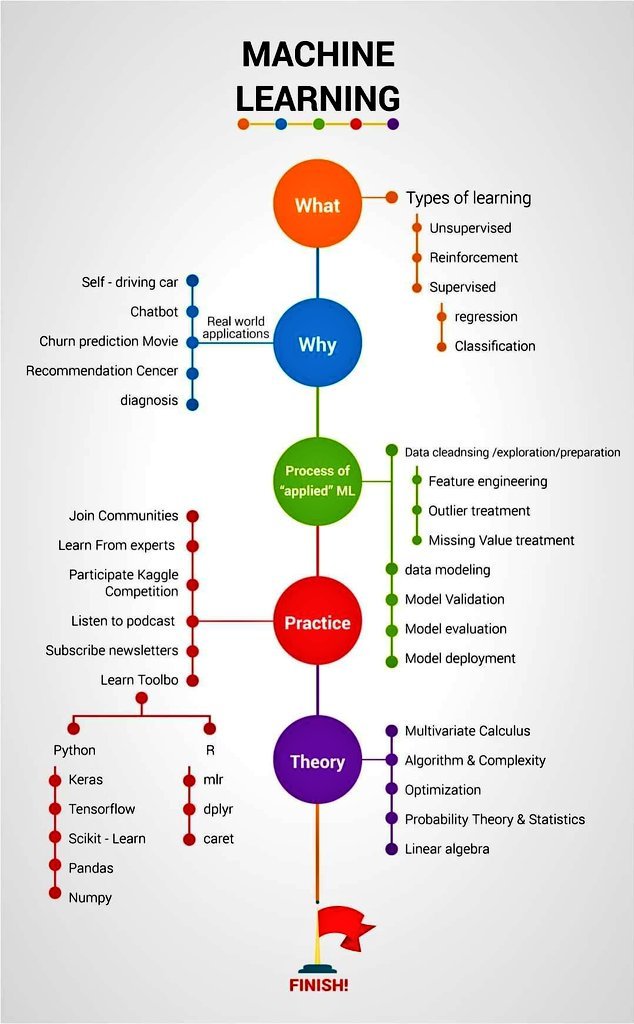
这是推特上Ternium的CIO发的一个图,关于机器学习理论和实践概念的信息图。这个图概括了机器学习实践流程的相关概念,简洁明了。对于入门的同学有很好的总结作用。
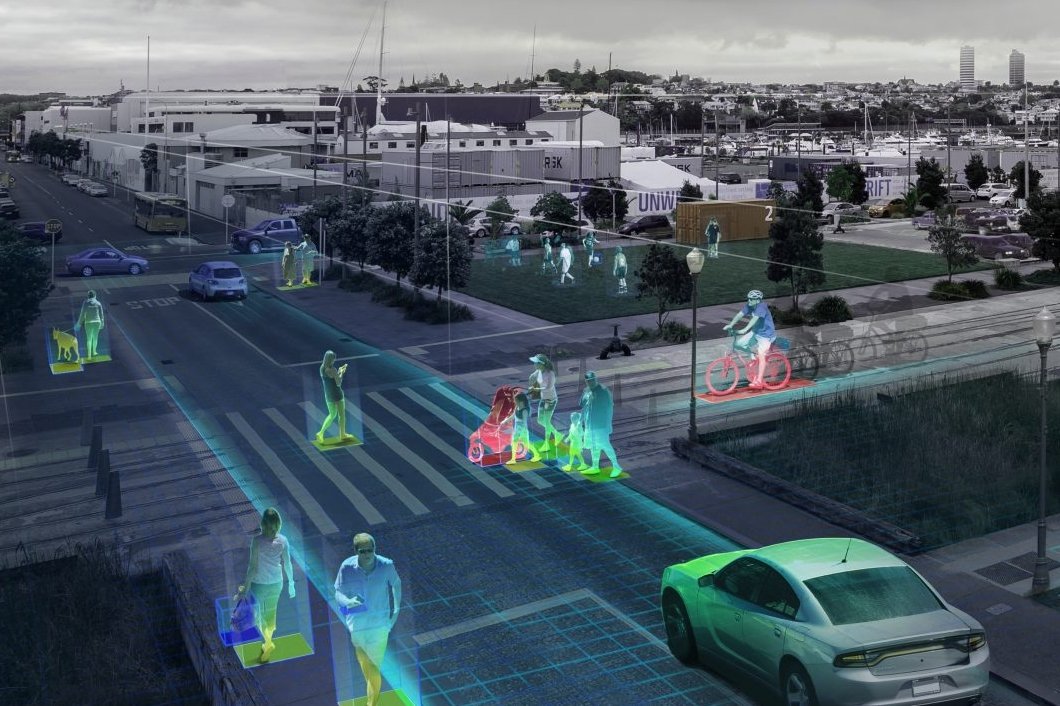
这是一篇来自Sayak Paul的预测,这个哥们长期混迹于各个开源社区,积极参与各大公司的开发者大会。目前在一家初创企业工作,简历非常丰富,非常积极在社区推广自己。但是不管怎么说,他在计算机视觉领域也是一直在一线工作。他对未来计算机视觉的发展方向有五个预测,虽然不一定准确,但是我们可以借助这个进行思考。
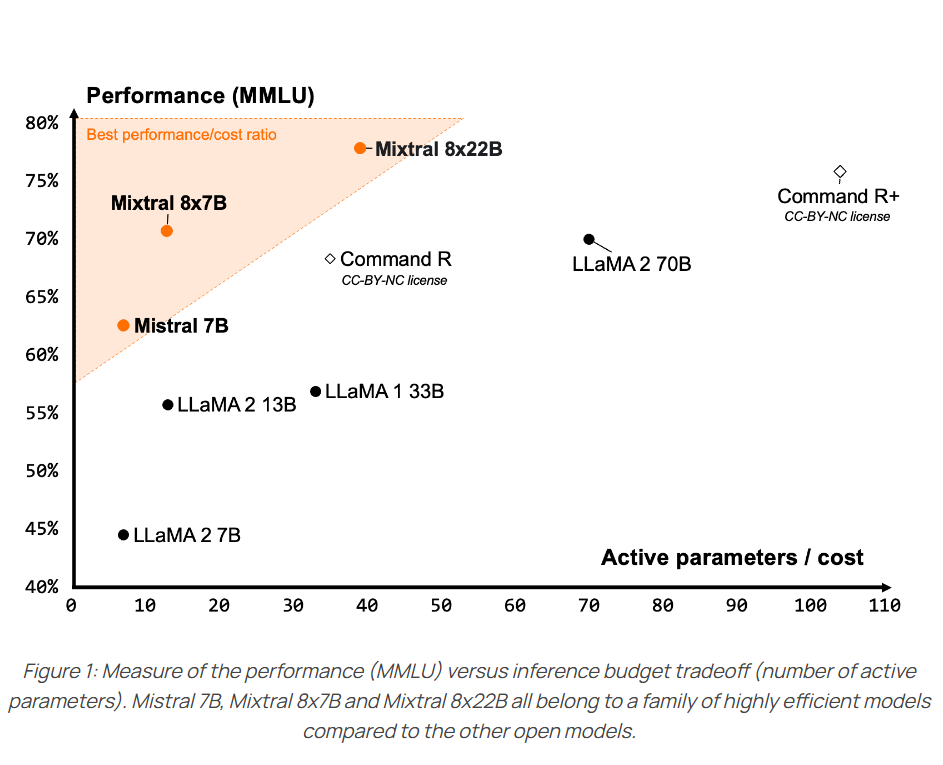
今天,MistralAI官方正式官宣了这个模型,并在HuggingFace上上架了两个不同的版本,一个是预训练基础模型Mixtral 8x22B,另一个则是指令优化的版本Mixtral-8x22B-Instruct。同时官网发布了博客介绍这个全新的大模型,并披露了更加详细的结果。
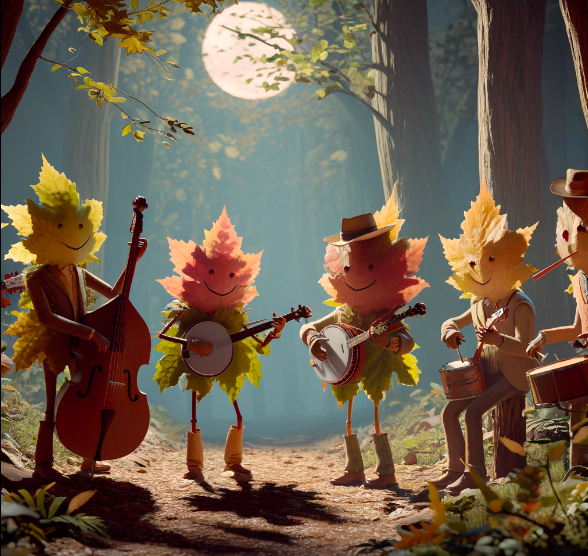
DALL·E 系列是由 OpenAI 开发的一系列基于大型语言模型的文本到图像生成系统。它们的核心目标是将文本描述转化为高度精确的图像。DALL·E2在2022年4月发布,但是一直没有公开使用,一年半后的2023年9月21日,OpenAI发布第三代DALL·E3,并承诺将与ChatGPT集成。
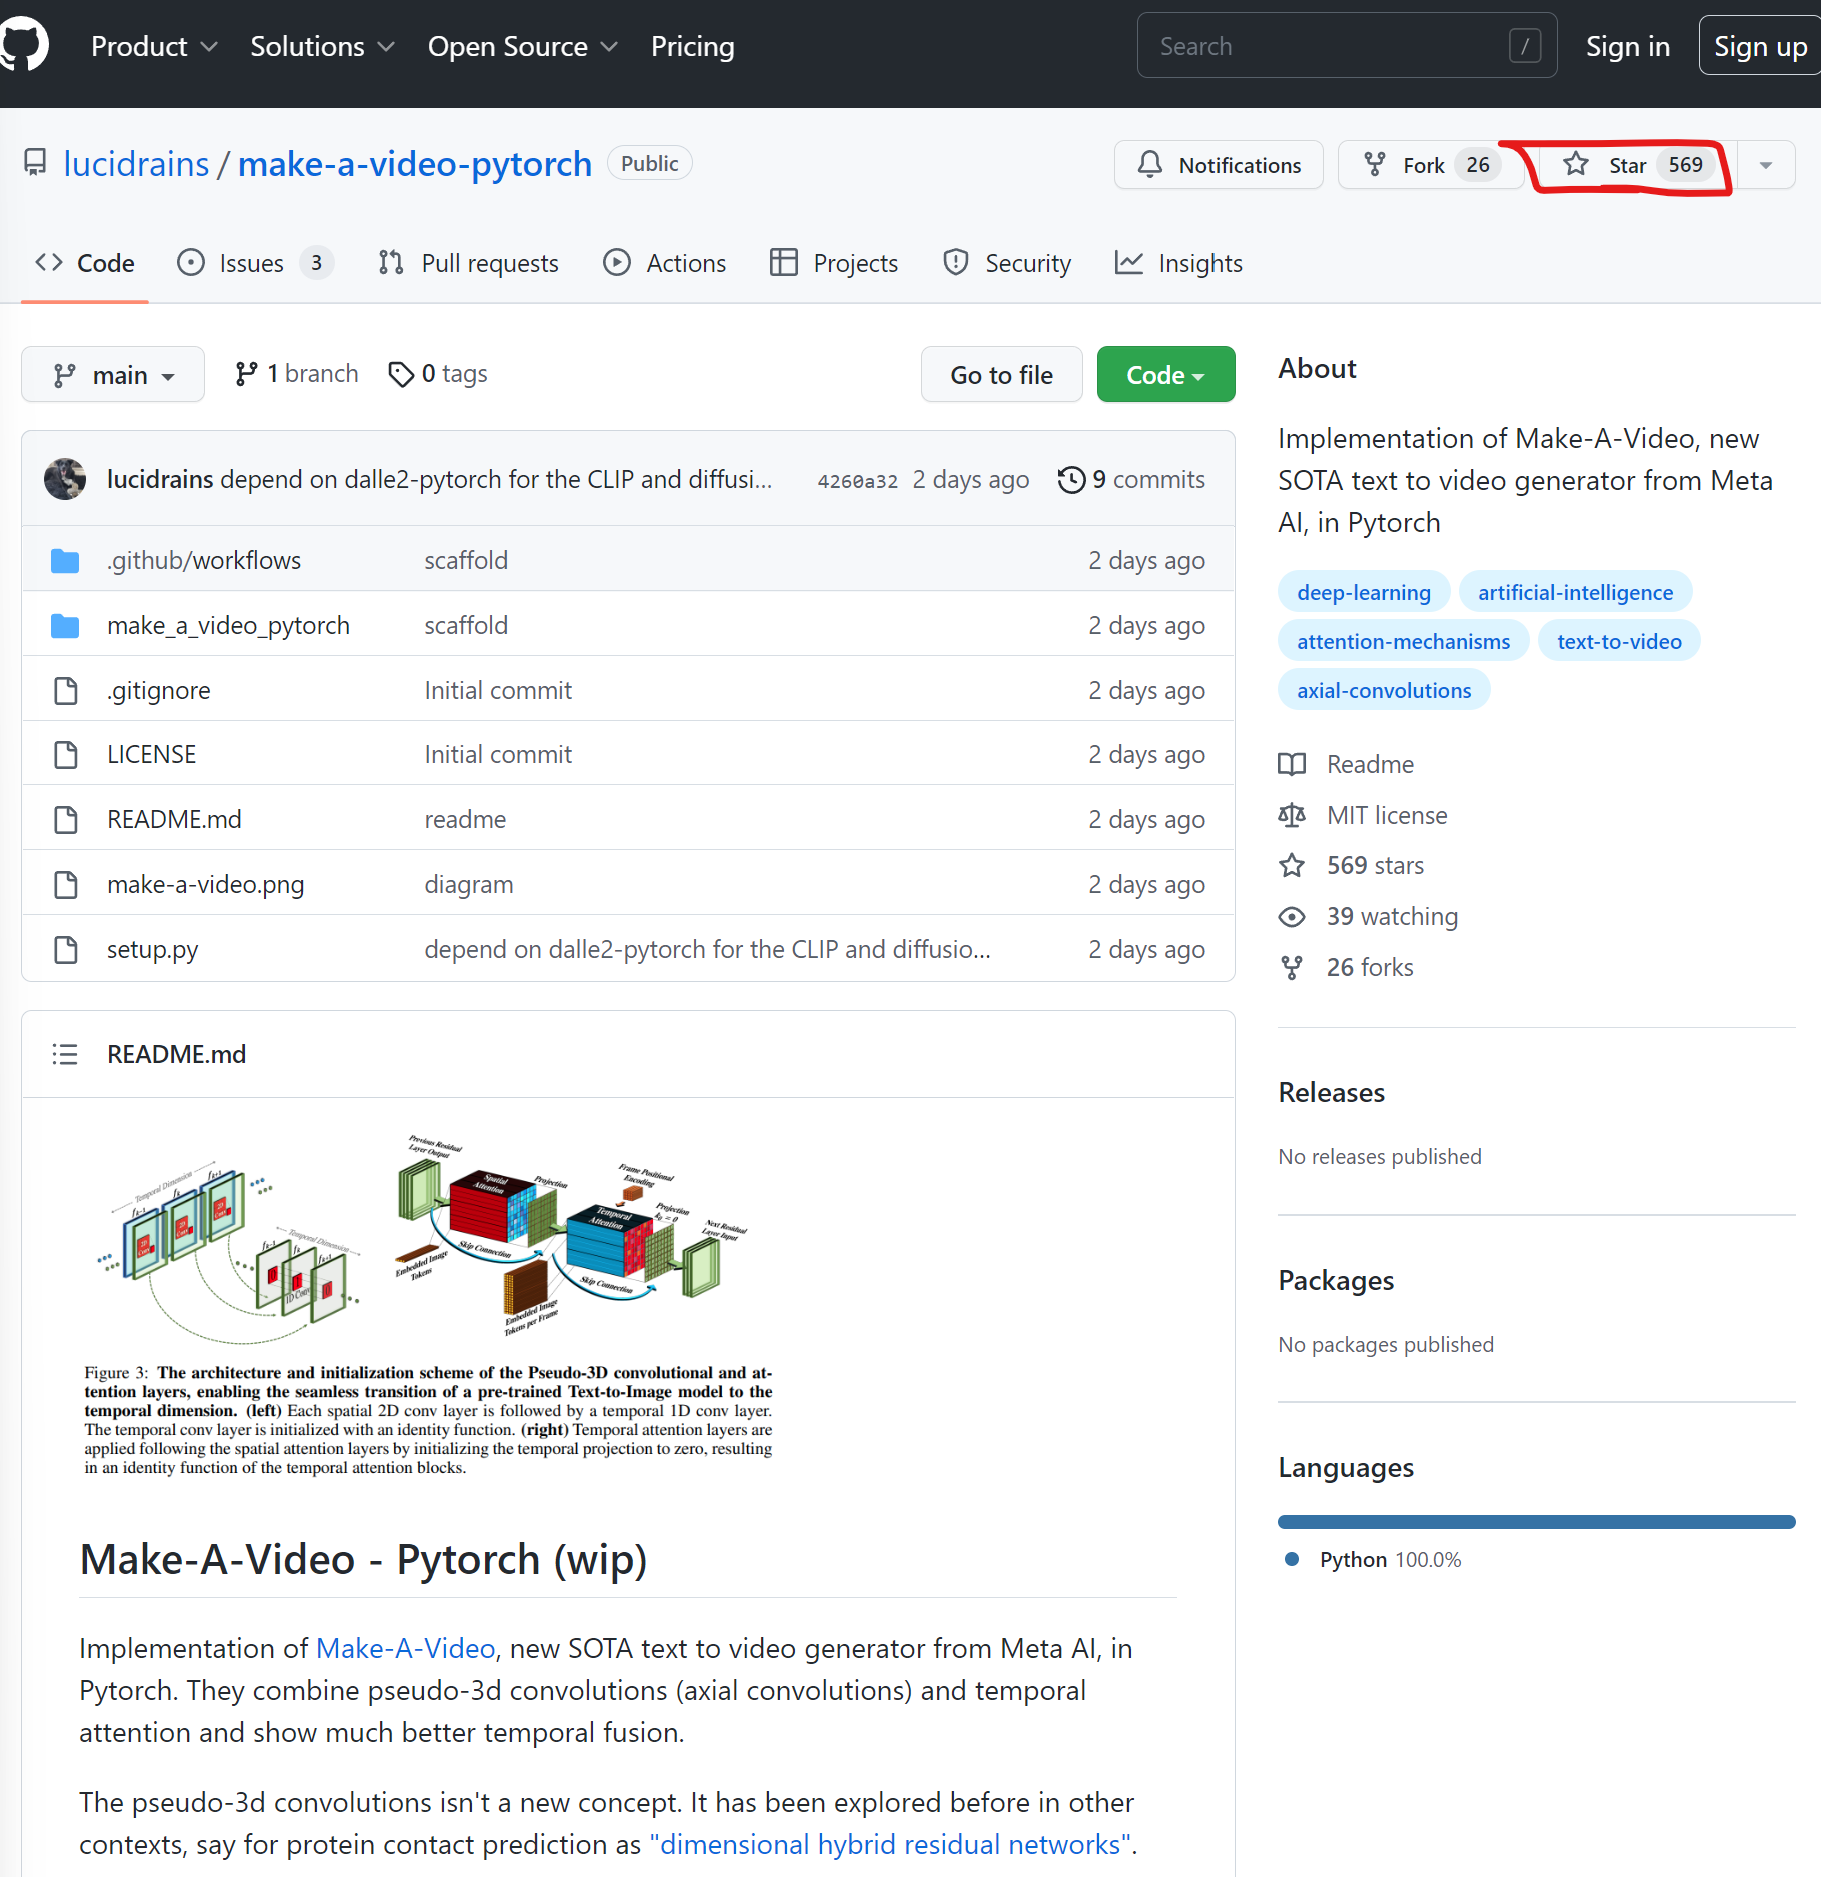
MetaAI在2天前刚发布了一个最新的Text-to-Video模型,让生成模型从逼真的图片生成往前推进到视频生成。当然,官方还是希望将其当作一种SaaS服务提供。但是,才2天,业界基于论文的开源PyTorch实现就已经准备公开,且获得了569个Star!卷到家了!
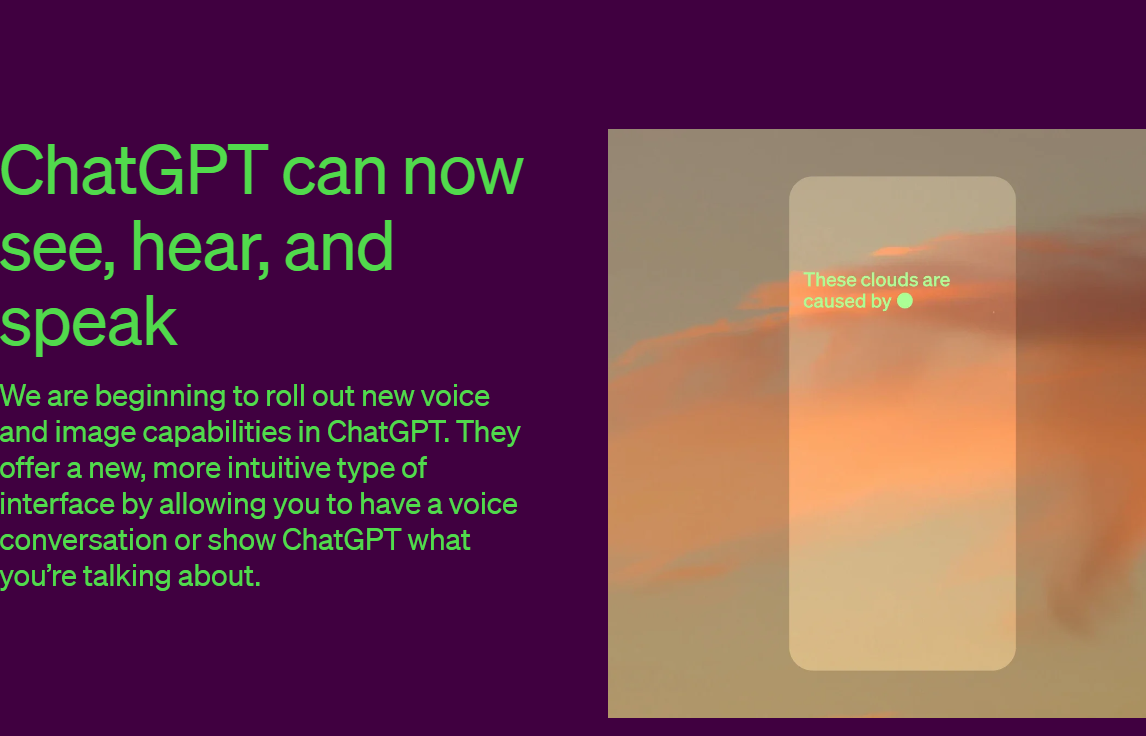
几分钟之前,OpenAI宣布ChatGPT支持多模态,目前已经支持语音的输入、语音的输出、理解图片的输入!不过目前似乎仅限于客户端~官方说的是未来2周内企业和Plus用户可以使用,后面会普及到其它用户!
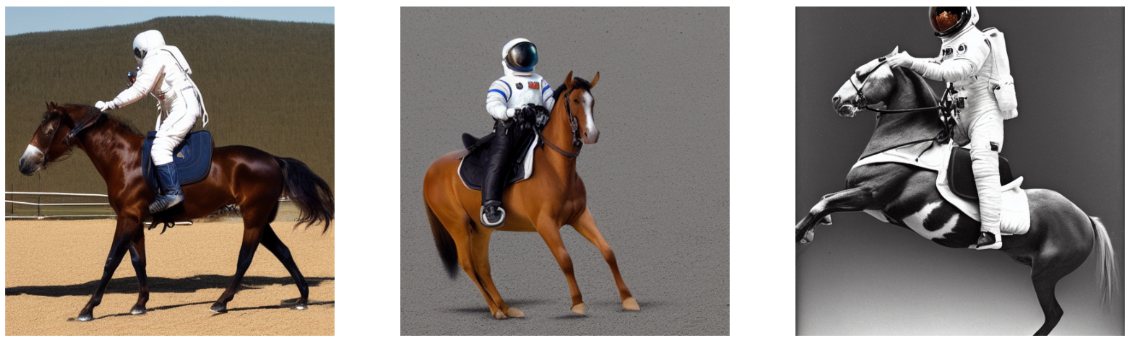
Stable Diffusion是一种功能强大的开源文本到图像(Text-to-Image)生成模型。虽然目前有多个开源项目可以实现基于文本提示(prompt)创建图像,但Stable Diffusion性能极其强大,其结果甚至可以媲美DALL·E2。而现在KerasCV提供了这个模型的官方实现!
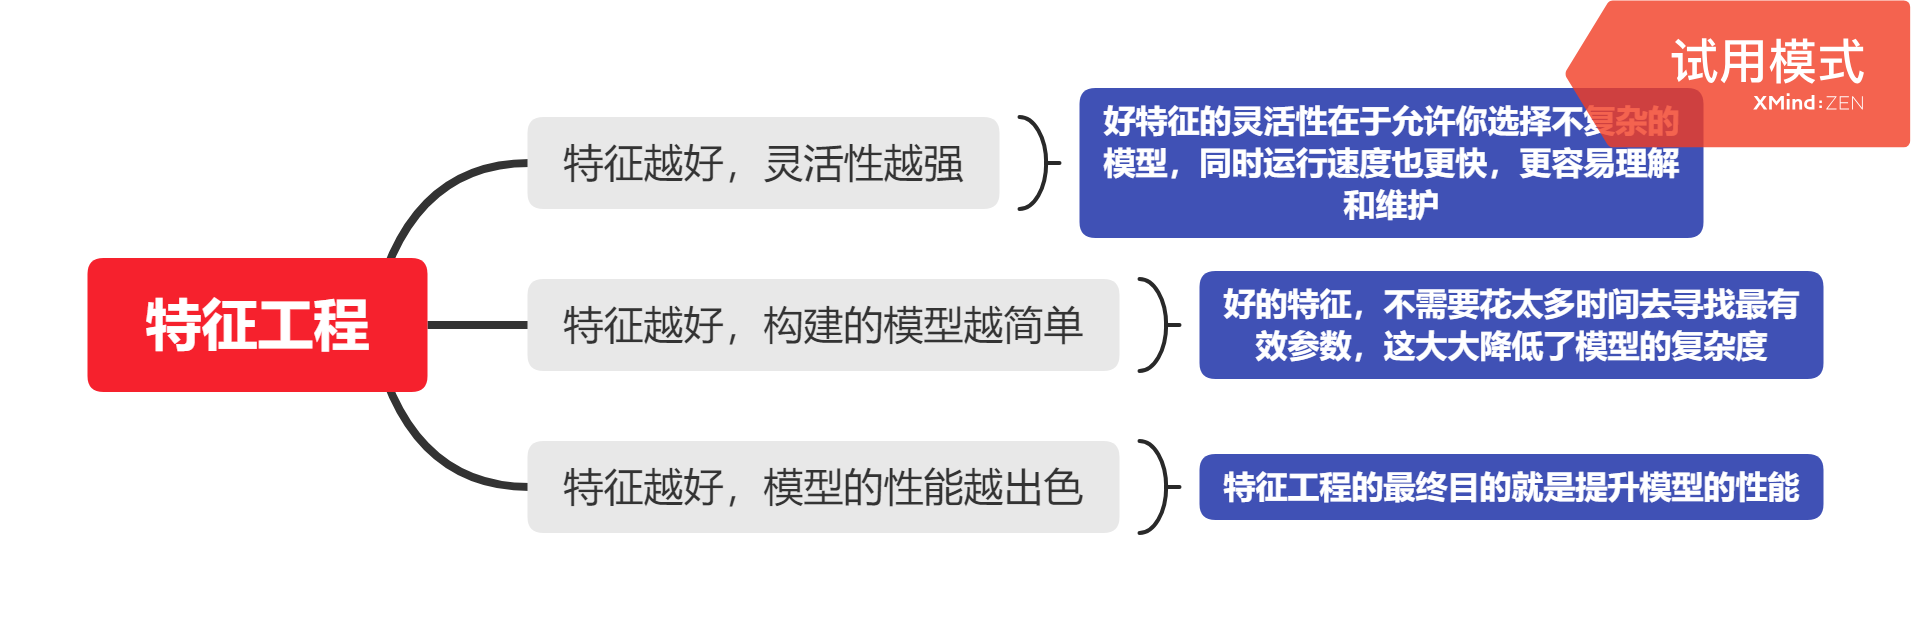
本篇是《阿里云天池大赛赛题解析-机器学习篇》的第一部分工业蒸汽量预测的第三章-特征工程的内容,并附带了一些知识点的网页链接。内有数据预处理、特征降维等内容。
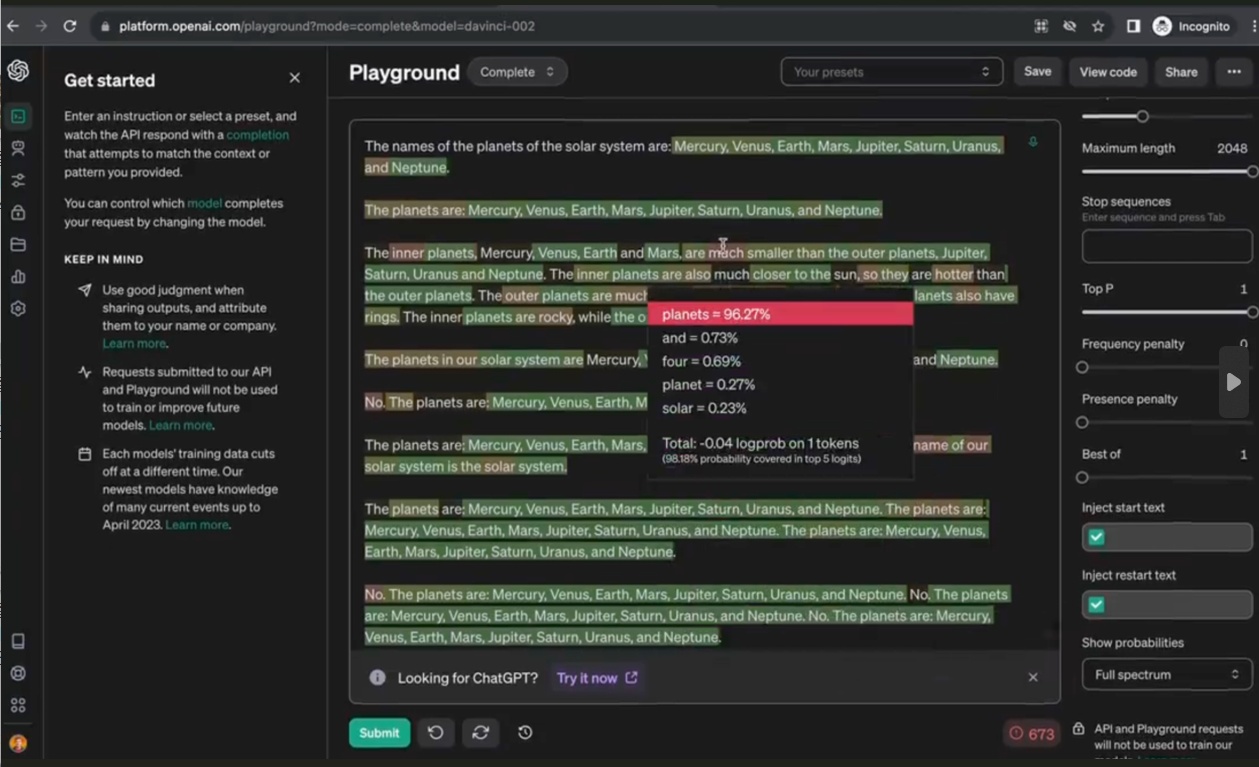
在最新的OpenAI官方接口文档中,新增了top_logprobs和logprobs这2个参数。这2个参数是一起配合使用的。后者是一个布尔类型,表明模型的返回结果中是否增加输出每个token的概率,而top_logprobs参数是一个整数类型,取值范围是0-5之间。如果top_logprobs设置为true,那么模型会根据top_logprobs的设置结果,返回输出结果中每个token及其后续的n个单词的概率。
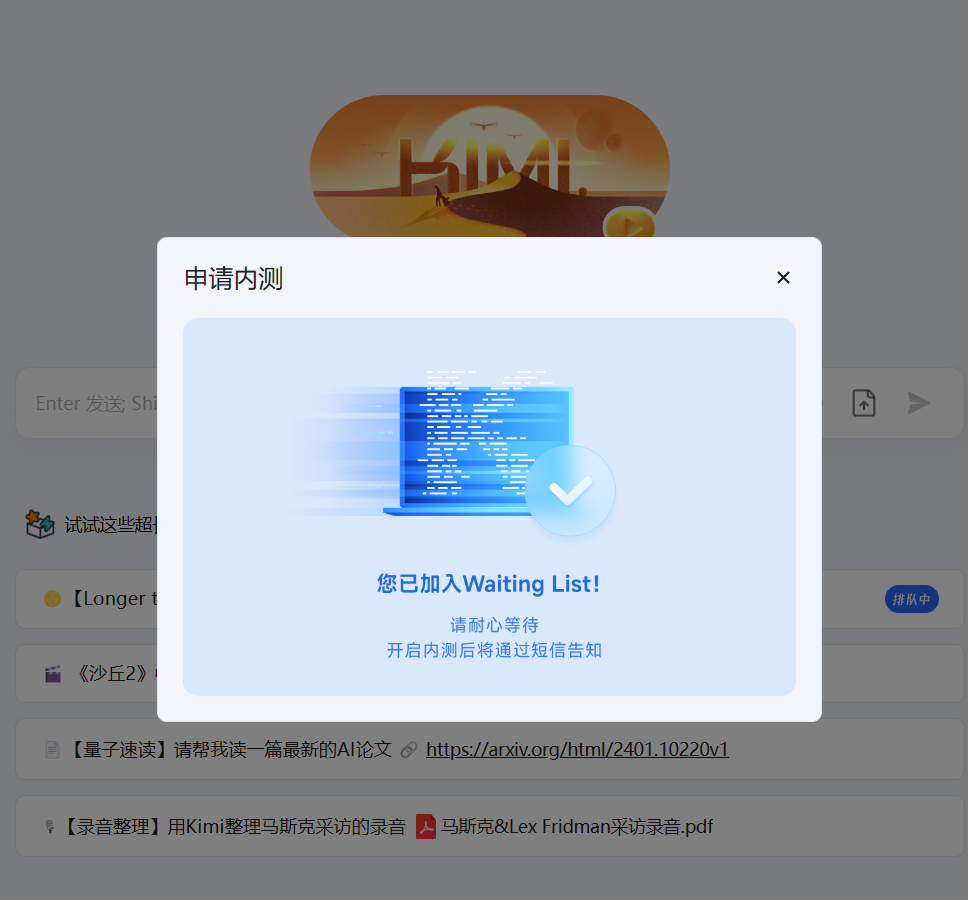
MoonshotAI(月之暗面)是一家中国的大模型初创企业,在2023年4月份成立。其最为著名的产品就是KimiChat,一个完全免费的大模型聊天机器人。就在刚刚,MoonshotAI官方宣布开启200万上下文的KimiChat内测!这应该是全球首个商业产品支持并内测200万上下文输入的模型了!此前其它产品宣布的200万上下文大多数都没有公开商发。
Bloomberg在2022年4月开源了Memray,这是一个Python的内存分析器。它可以跟踪Python代码、本地扩展模块和Python解释器本身的内存分配情况。可以看numpy和pandas的运行内存使用。
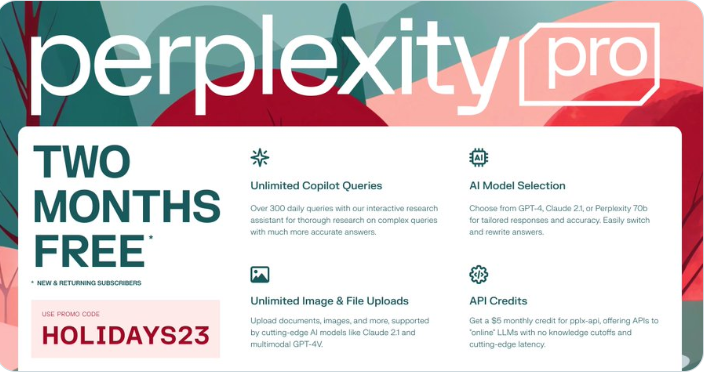
PerplexityAI是通过搜索引擎检索互联网的内容,然后使用大模型总结答案。产品形态有点像Bing的Bing Chat。圣诞节前夕,PerplexityAI提供了一个优惠代码,可以免费使用他们的2个月的Pro版本订阅服务。PerplexityAI的Pro版本提供GPT-4、Claude-2.1等大模型服务,支持生成图片和基于很长的PDF问答,这2个月的服务十分划算!
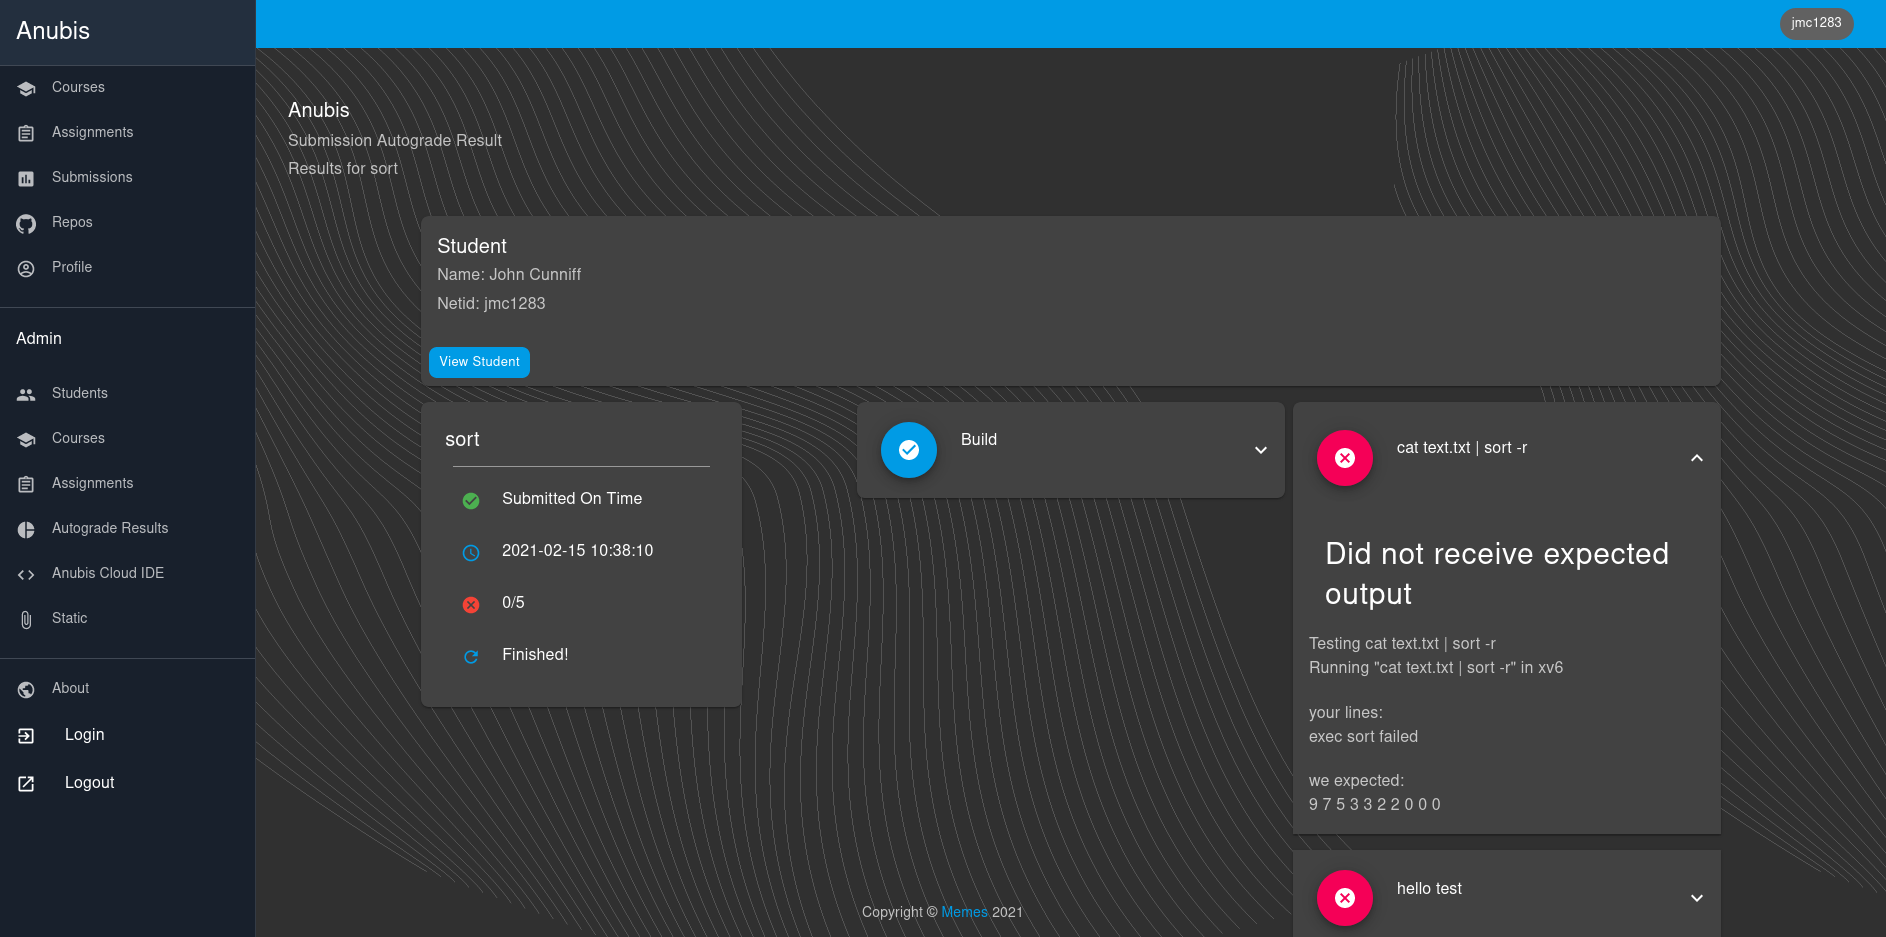
Anubis是一个分布式LMS(学习管理系统),由John Cunniff创建,专门为CS课程的自动化而设计。Anubis已经在纽约大学坦登分校使用并经过了几个学期的测试。这个系统的主要目的是自动为提交的作业评分,并提供了一个云IDE解决方案,以简化学生的体验。
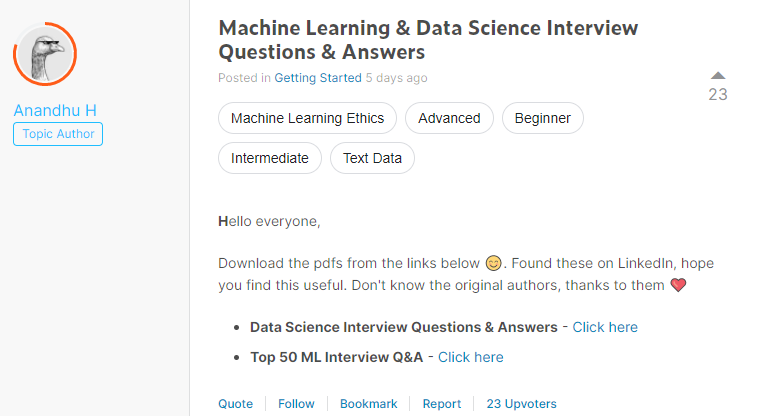
这是来自Kaggle上网友的分享,是关于数据科学和机器学习的面试题集锦。都是英文的题目,不过应该不影响,大家也可以根据题目自己去寻找答案,我看了一下,并不是所有的答案都非常准确,但问题的确可以帮助我们思考总结。
零一万物(01.AI)是由李开复在2023年3月份创办的一家大模型创业企业,并在2023年6月份正式开始运营。在2023年11月6日,零一万物开源了4个大语言模型,包括Yi-6B、Yi-6B-200K、Yi-34B、Yi-34B-200k。模型在MMLU的评分上登顶,最高支持200K超长上下文输入,获得了社区的广泛关注。