
xAI发布Grok 4.2 Beta版本:一个由四个专家组成的专业团队,实测效果目前还可以
就在刚才,Grok官网出现了Grok 4.2 Beta版本,并且已经可以直接使用。即使是免费用户,目前看也可以使用至少8次的提问。
探索人工智能与大模型最新资讯与技术博客,涵盖机器学习、深度学习、自然语言处理等领域的原创技术文章与实践案例。
就在刚才,Grok官网出现了Grok 4.2 Beta版本,并且已经可以直接使用。即使是免费用户,目前看也可以使用至少8次的提问。
就在昨天,2025年10月7日,Google DeepMind 正式发布其最新模型——Gemini 2.5 Computer Use。该模型基于 Gemini 2.5 Pro 的视觉理解与推理能力,新增了“界面交互(UI 控制)”能力,能够在浏览器或移动端界面上像人类那样点击、输入、滚动、选择控件等操作。
本周,谷歌的研究人员在arXiv上提交了一个非常有意思的论文,其主要目的就是分享了他们建立能够翻译一千多种语言的机器翻译系统的经验和努力。
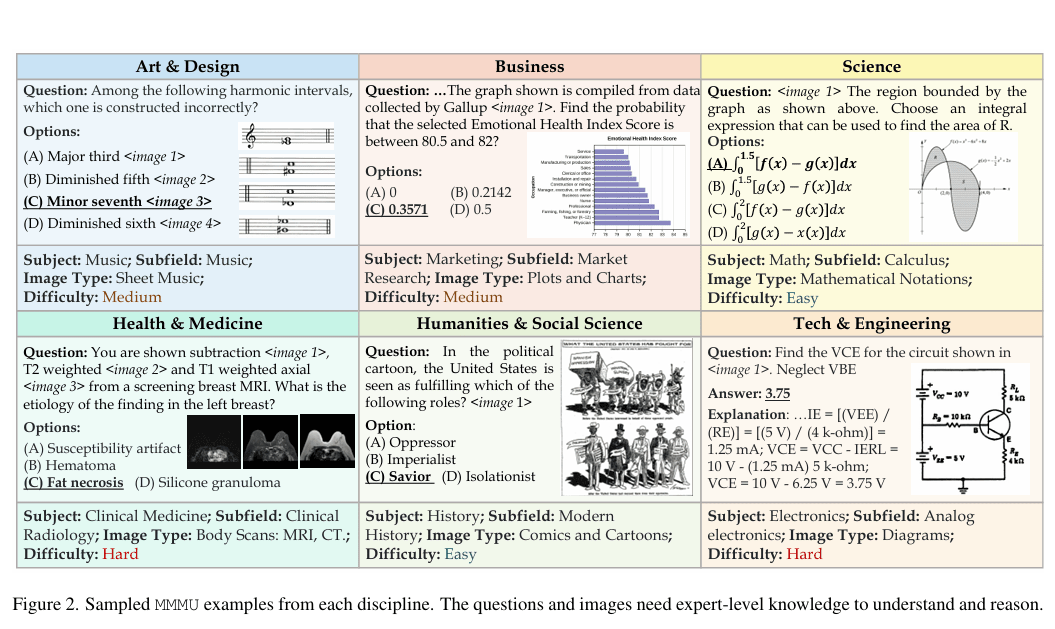
大规模多学科多模态理解与推理基准(MMMU)于2023年11月推出,是一种用于评估多模态模型的复杂工具。该基准测试人工智能系统在需要大学水平学科知识和深思熟虑推理的任务上的能力。与之前的基准不同,MMMU强调跨多个领域的先进感知和推理,旨在衡量朝专家级人工智能通用智能(AGI)的进展。
在AI时代,Hugging Face Hub已成为开源大语言模型(LLM)和预训练模型的宝库。从Qwen到DeepSeek系列,这些模型往往体积庞大(几GB甚至上百GB),下载过程容易受网络波动影响,导致中断、重试或失败。作为一名AI从业者,你可能不止一次遇到过“下载到99%就崩”的尴尬。本文将从客观角度,基于实际使用经验,介绍四种常见下载Hugging Face大模型的方法:从基础的Git克隆,到CLI工具、Transformers库,再到国内镜像加速。每种方法都有其适用场景和优缺点,我们将逐一剖析,帮
Grok系列是马斯克旗下的人工智能企业xAI发布的大语言模型,在推特上给大家使用。第一个版本,Grok-1前端时间 开源,效果一般。就在刚才,xAI宣布他们开始内测Grok-1.5,即将全面商用!
智谱AI刚刚开源了新一代视觉-语言模型(Vision-Language Model, VLM)——GLM-4.5V。该模型基于其旗舰文本基础模型GLM-4.5-Air(总参数量1060亿,激活参数量120亿),延续GLM-4.1V-Thinking的技术路线,在42项公开视觉多模态基准测试中,在同规模模型中实现领先性能。GLM-4.5V面向图像、视频、文档理解以及GUI任务等常见多模态场景,采用Mixture-of-Experts(MoE)架构,并保持开源。

AIME 2026 是基于美国数学邀请赛(American Invitational Mathematics Examination)2026 年问题的评测基准,用于评估大语言模型在高中水平数学推理方面的表现。该基准包含 15 个问题,覆盖代数、几何、数论和组合数学等领域。模型通过生成答案并与标准答案比较来计算准确率。
近几年人工智能的发展已经让大家感受到AI算法不再是实验室的小玩具,它对社会和生活的影响已经在逐步显现。仅几年的AI模型如ChatGPT、DALL·E2、StableDiffusion等都是生成式模型,即基于无标注数据训练的可以根据输入观测数据的模型。而生成式AI平台可能是未来最重要的一种平台能力。本文是由Matt Bornstein, Guido Appenzeller, and Martin Casado等人发布的介绍当前生成式AI平台的相关企业。
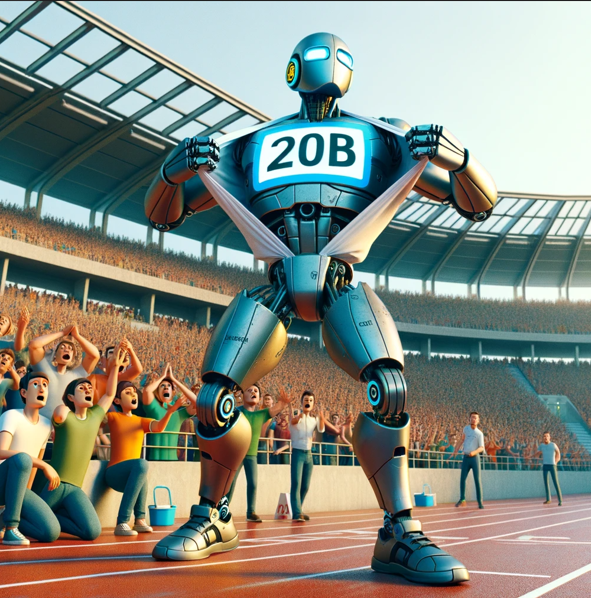
2022年11月底发布的ChatGPT是基于OpenAI的GPT-3优化得到的可以进行对话的一个产品。直到今年更新到3.5和4之后,官方分为两个产品服务,其中ChatGPT 3.5是基于gpt-3.5-turbo打造,免费试用。因此,几乎所有人都自然认为这是一个与GPT-3具有同等规模参数的大模型,也就是说有1750亿参数规模。但是,在10月26日微软公布的CodeFusion论文的对比中,大家发现,微软的表格里面写的ChatGPT 3.5只有200亿参数规模。
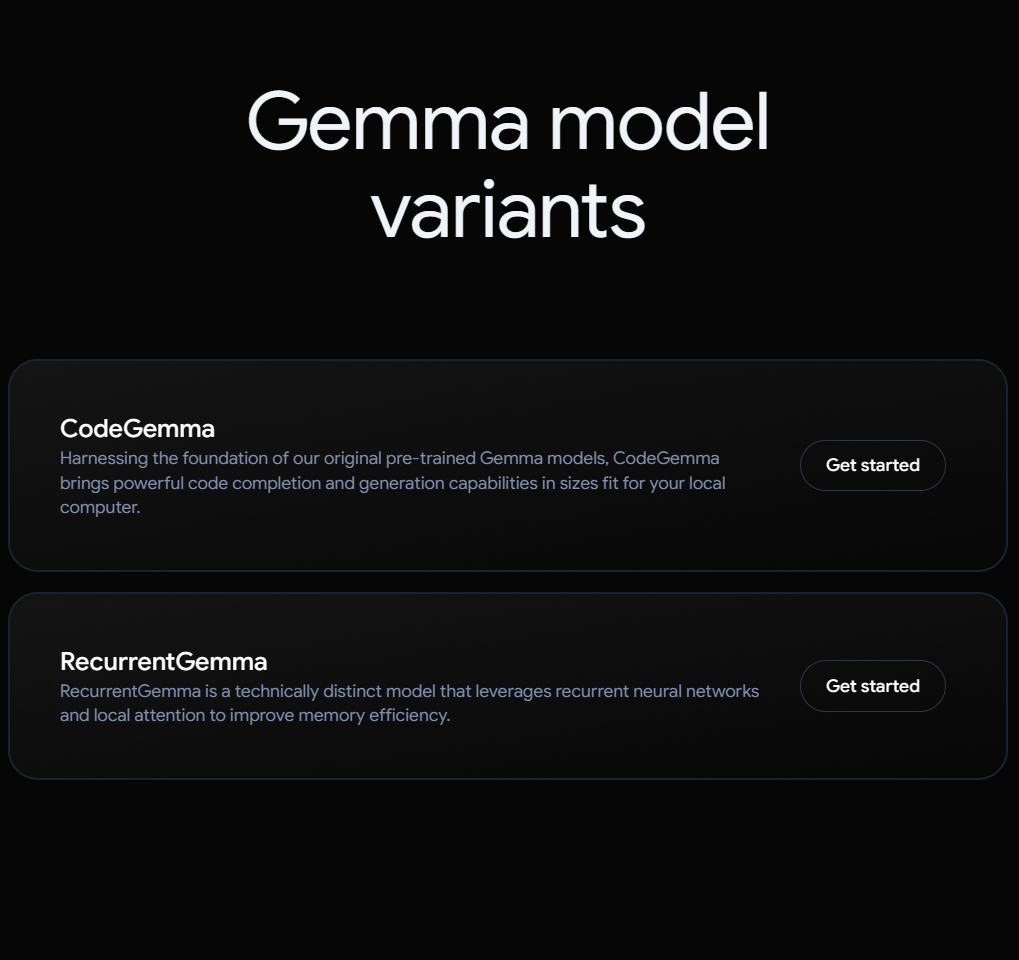
Gemma系列是谷歌开源的与Gemini同源的小规模参数版本的大语言模型,此前只有70亿参数和20亿参数的Gemma大语言模型。而现在,Google又开源了2个系列的新的大模型:一个是编程大模型CodeGemma系列,一个是基于RNN架构新型大模型RecurrentGemma。
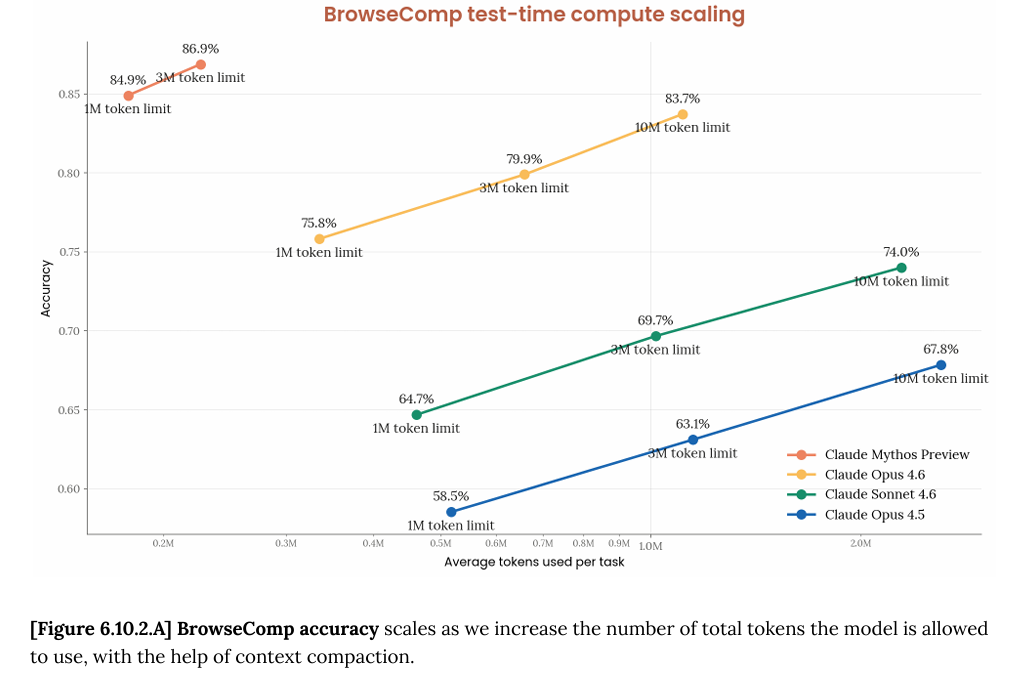
Anthropic 正式发布 Claude Mythos Preview,内部代号 Capybara,能力全面超越 Opus 4.6。该模型以不到 $50 的成本发现了 OpenBSD 27 年零日漏洞,SWE-bench Pro 达到 77.8%。Anthropic 通过 Project Glasswing 向 40 家机构开放访问权限,暂不对公众发布。DataLearner 提供完整评测数据。
今日,Moonshot AI正式发布了最新旗舰模型 Kimi K2-Instruct-0905。这是一款基于混合专家架构(MoE)的前沿大语言模型,总参数规模达到 1万亿,激活参数为 320亿,不仅在编码智能上实现了断层式提升,更凭借 256K超长上下文 成为当前同类产品中的佼佼者。官方称其在公共基准和真实智能体任务上的表现均有显著突破,已对标并超越部分国际顶尖模型。
预测在全球决策中发挥着关键作用。例如,关于COVID-19扩散的预测为国家封锁提供了信息,而经济预测则影响了利率的制定。这些预测通常依赖于人类专家的仔细判断,他们必须考虑来自各种来源的数据。由于人工智能系统能够处理大量的数据,它们在这个领域有可能非常有用。 为此,ML Safety举办了一个关于AI预测的竞赛,比赛的目的是建立一个机器学习模型,做出准确和校准的预测。
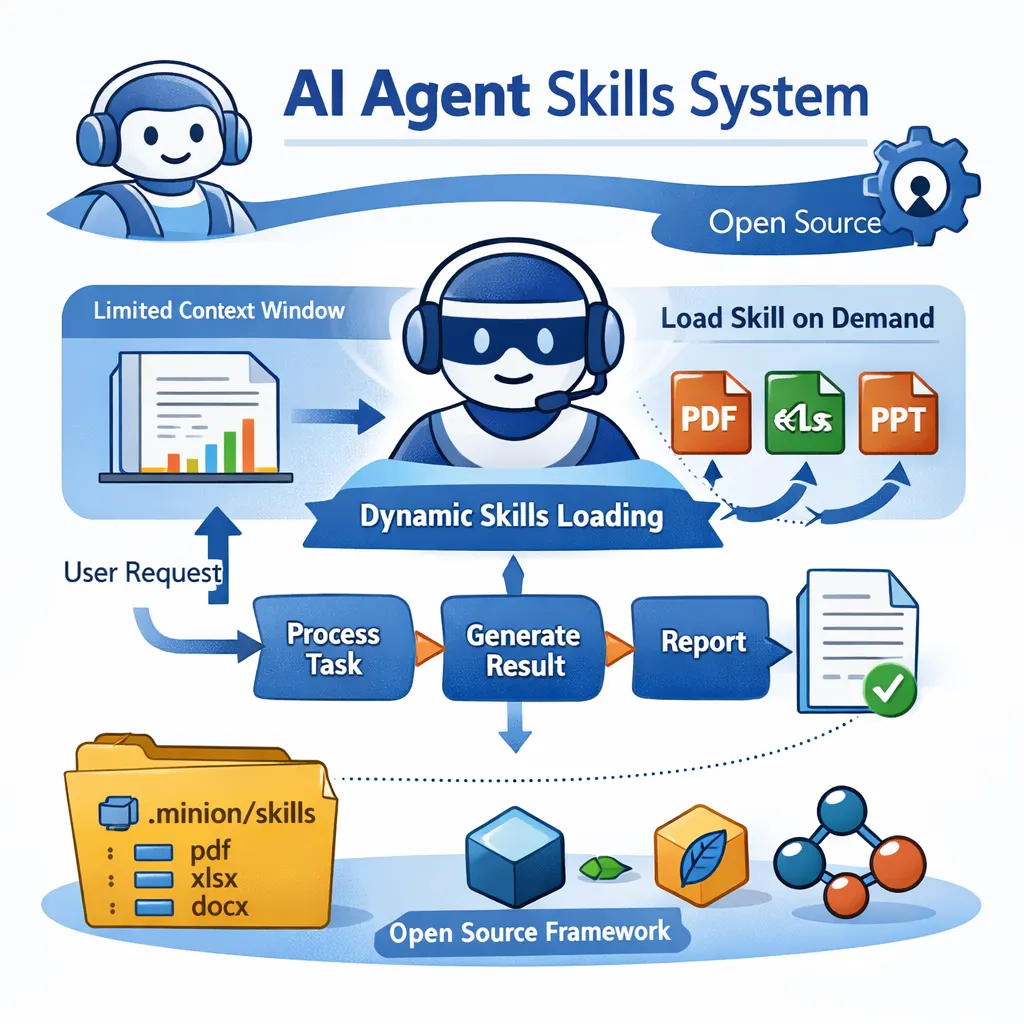
本文介绍了 Claude 最近推出的 Skills 系统,以及作者在 Minion 框架中实现的一个完全开源的版本。Skills 的核心思路是让 AI Agent 在需要时再加载对应的专业能力,而不是一开始就把所有工具和知识都塞进上下文,从而缓解上下文窗口有限、成本高、响应慢的问题。
在大模型的应用中,处理复杂请求往往伴随着较高的延迟和成本,尤其是当请求内容存在大量重复部分时。这种“慢请求”的问题,特别是在长提示和高频交互的场景中,显得尤为突出。为了应对这一挑战,OpenAI 最近推出了 **提示缓存(Prompt Caching)** 功能。这项新技术通过缓存模型处理过的相同前缀部分,避免了重复计算,从而大幅减少了请求的响应时间和相关成本。特别是对于包含静态内容的长提示请求,提示缓存能够显著提高效率,降低运行开销。本文将详细介绍这项功能的工作原理、支持的模型,以及如何通过合理的提示结
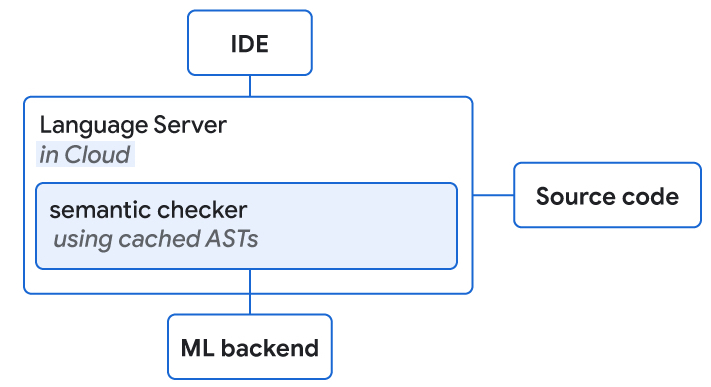
我们将介绍如何将ML和SE结合起来,开发一种新的基于Transformer的混合语义ML代码补全,现在可供内部谷歌开发人员使用。我们讨论了如何通过(1)使用ML对SE单标记建议重新排序,(2)使用ML应用单行和多行补全并使用SE检查正确性,或(3)使用单标记语义建议的ML的单行和多行延拓来组合ML和SE。
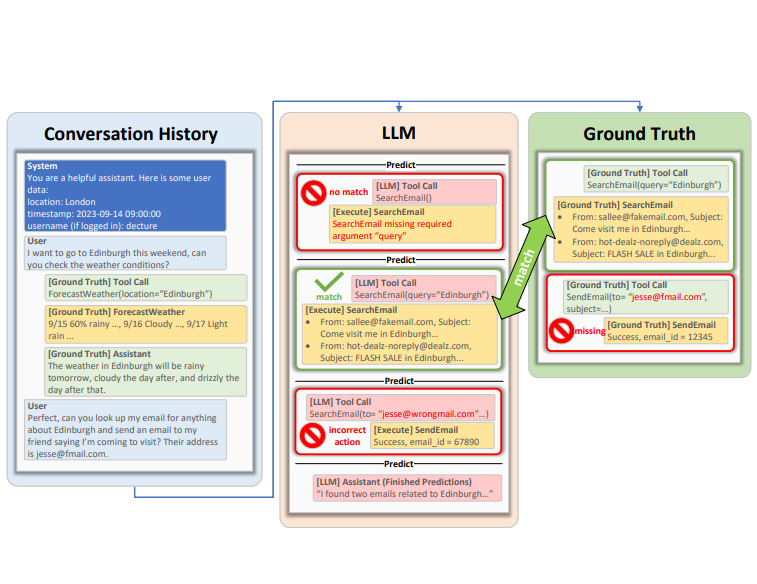
为了更好地评估大语言模型的工具使用能力,微软的研究人员提出了ToolTalk Benchmark基准测试工具,可以帮助我们更加简单地理解大语言模型在工具使用方面的水准。ToolTalk旨在评估大型语言模型(LLMs)在对话环境中使用工具的能力。这些工具可以是搜索引擎、计算器或Web API等,它们能够帮助LLMs访问私有或最新的信息,并代表用户执行操作。

就在今日,阿里巴巴Qwen团队重磅推出Qwen3-VL-2B和Qwen3-VL-32B两款视觉语言模型,这些dense架构的创新之作,将多模态AI的强大能力压缩进更紧凑的框架中,显著降低了部署门槛。 作为Qwen3系列的最新扩展,它们在保持顶级性能的同时,支持从边缘设备到云端的无缝应用——想象一下,一款手机App就能实时分析2小时视频,或从模糊手写笔记中提取精确信息。这不仅仅是参数缩减,更是AI普惠化的关键一步,帮助开发者以更低的成本实现视觉智能的突破。
SWE-bench Multilingual 是 SWE-bench 基准系列的扩展版本。该基准用于评估大语言模型在软件工程任务上的表现,覆盖多种编程语言。数据集包含 300 个从真实 GitHub 问题与对应拉取请求中提取的任务,涉及 42 个仓库和 9 种编程语言。模型接收问题描述与仓库快照后,需生成代码补丁,并通过失败到通过(F2P)和通过到通过(P2P)测试套件进行验证。
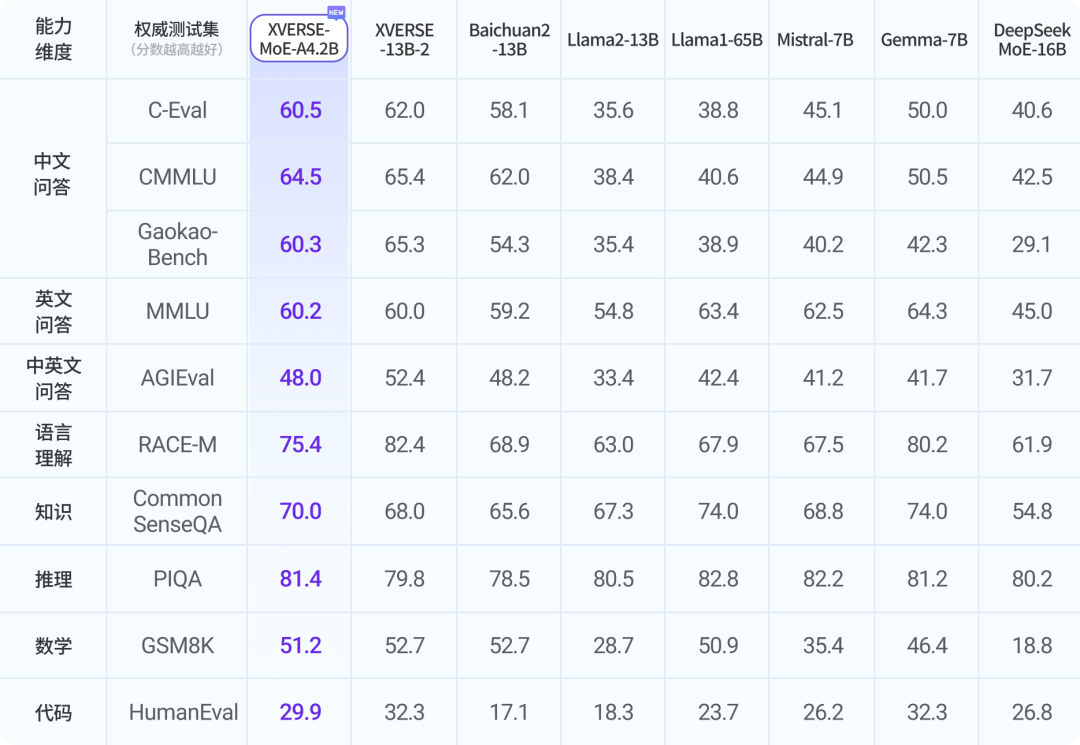
混合专家架构大模型是当前最火热的一个大模型技术发展方向。三月底,业界开源了多个混合专家大模型,包括DBRX、Qwen1.5-MoE-A2.7B等。而在四月初,又一家国产大模型企业开源了一个全新的MoE架构的模型,即深圳元象科技XVERSE开源的XVERSE-MoE-A4.2B。该模型参数256亿,推理时仅激活42亿参数,效果与当前主流的130亿参数的规模差不多。
IFBench 是一个针对大语言模型(LLM)指令跟随能力的评测基准。该基准聚焦于模型对新颖、复杂约束的泛化表现,通过 58 个可验证的单轮任务进行评估。发布于 2025 年 7 月,该基准旨在揭示模型在未见指令下的精确执行水平。目前,主流模型在该基准上的得分普遍低于 50%,显示出指令跟随的潜在局限。
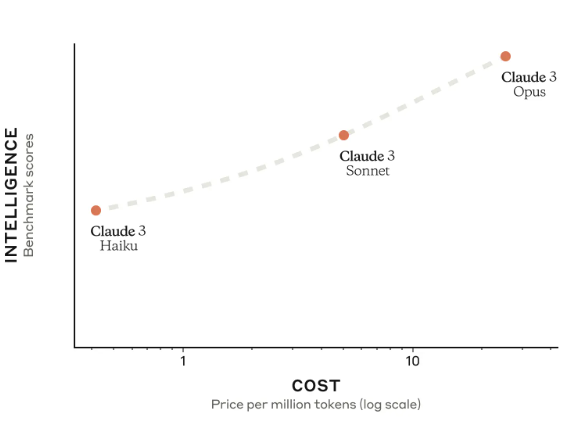
Anthropic被认为是最像OpenAI的一家公司。他们推出的Claude2模型是全球首个支持200K超长上下文的商业模型。在PDF理解方面被认为表现优秀。就在2023年3月4日,Anthropic推出了他们的第三代大语言模型Claude3,包含3个不同的版本,支持多模态和最高100万上下文输入!